生成AIの情報漏洩対策は、どの情報が、どこへ渡り、誰に見えるかを経路ごとに確認します。 学習への利用をオフにする設定は、そのうちの一つです。入力した会話の共有、サービス内での保存、連携先の権限、回答の送信先も点検します。
ここでは中小企業の経営者や情報システム担当者が確認しやすいよう、入力・学習と保存・連携・出力の4経路に分けます。これは業務を点検するための分類で、事故原因を網羅する統計分類ではありません。サービス提供者側の不具合やアカウントの乗っ取りは、複数の経路に影響します。(調査時点: 2026年11月)
4つの経路で確認すること
| 経路 | 業務で想定する場面 | 確認する事項 |
|---|---|---|
| 入力・共有 | 問い合わせを貼り付けた会話を社外へ共有する | 入力禁止情報、添付ファイル、会話の共有範囲 |
| 学習・保存 | 入力がモデル改善や履歴保存の対象になる | 契約プラン、学習設定、保存・削除条件 |
| 外部連携 | AIがメールや社内ストレージを参照する | 接続先、参照範囲、送信・更新権限、承認者 |
| 出力・送信 | 社内向けの情報を回答に含めて顧客へ送る | 参照元、宛先、添付、送信前の確認 |
たとえば問い合わせの返信案を作る仕事なら、受信メールを入力する段階、社内資料を検索する段階、回答を送る段階で扱う情報が変わります。「このAIを使ってよい」という許可に加え、認める用途と情報の範囲を決めると、担当者が判断しやすくなります。
入力した情報は共有先まで確認する
顧客への返信案だけを見せるつもりでも、会話に顧客情報や社内のメモを入力していれば、共有する範囲の確認が必要です。ChatGPTの共有リンクの公式説明では、リンクを知る人が対象の会話を閲覧できるとされています。共有リンクの削除後も、相手が履歴へ取り込んだコピーまで削除できるとは限りません。
入力前には、氏名や連絡先に加えて、注文番号、添付画像、自由記述の相談内容を確認します。名前を伏せても、他の情報との組み合わせで本人が分かる場合があります。業務に必要のない情報は入力対象から外し、社内だけで使う会話を外部共有しないルールを用意します。
これは、入力した情報が直ちに他の利用者へ公開されるという説明ではありません。自社がサービスへ情報を送ることと、その後に第三者が閲覧することを区別して点検します。漏洩の疑いがあれば、共有や連携を停止しつつ記録を保全します。対応の順序は情報漏洩が起きたときの初動で扱っています。
学習の停止と保存の停止を分けて確認する
モデル改善への利用、会話履歴の保存、不正利用の監視、連携先への送信は、それぞれ目的と条件が異なります。学習をオフにしたという事実だけで、情報が保存されないとは判断できません。
下の公式ヘルプ画像は、ChatGPTの学習設定を説明する画面です。右側のモデル改善のスイッチと、共有リンクの管理や会話の削除が別項目になっています。実際の表示名や位置は、言語や更新によって変わります。
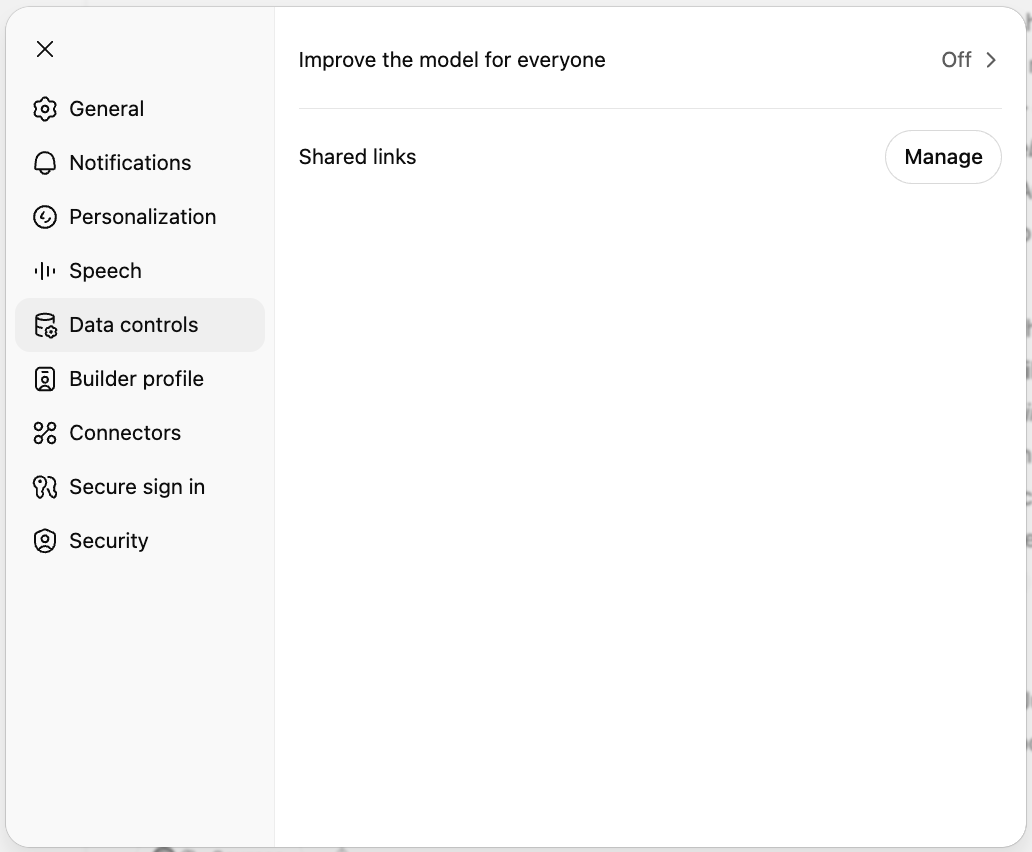
同ヘルプでは、学習への利用をオフにしても会話は履歴に表示されると説明されています。利用時は、契約するプランの規約で保存期間、削除の方法、管理者の権限を確認してください。個人向けサービスの設定を、そのまま法人契約やAPIの仕様として扱わないことも必要です。
外部連携では参照と実行の権限を分ける
社内ストレージやメールにAIを接続すると、手作業で貼り付ける情報以外にもアクセスできるようになります。接続前に、対象のフォルダやメールボックスを確認し、必要な範囲に絞ります。検索できる権限と、メール送信・ファイル削除を実行する権限は別々に判断します。
外部から届いたメールやWebページには、AIへの指示を装った文章が含まれる可能性もあります。対策として、外部の文章を業務上の命令として扱わせない設計に加え、操作権限の制限、送信前の確認、停止手段を組み合わせます。指示文に注意書きを加えるだけで防止を保証するものではありません。
利用を終えた接続は解除し、退職者や異動者のアカウントも見直します。接続トークンの保管者、権限を変更できる人、異常時に止める人まで決めておくと、事故の疑いがあるときに対応先を探す時間を減らせます。
出力は回答内容と送信先を点検する
AIの回答が正しいことと、その相手に渡してよいことは別の確認です。社内の原価、未公開の契約条件、別の顧客の事情を参照できる環境では、回答に何を含めるかを制限します。返信案の作成と送信を工程として分け、宛先・添付・回答の根拠を確認します。
出力の監査ログを取得する場合も、会話全文に機密情報が含まれないかを確認してください。ログを閲覧できる人、保存期間、削除方法を決め、調査に必要な記録と、保存する情報量の両方を検討します。
公表事例では原因と影響を読み分ける
OpenAIは2023年3月24日、同月20日の障害について、ライブラリの不具合で一部の利用者に別の利用者の会話タイトルなどが見える状態になったと公表しました。同社は修正済みと説明しています。これは学習設定による共有の事例ではなく、サービス側の処理の不具合として公表されたものです。
事例を社内で共有するときは、発生日、公表日、影響した情報、原因、修正状況を分けて記録します。「AIの情報漏洩」という見出しだけでは、自社の入力ルールを直すべきか、サービス側の対応を確認すべきか判断できません。古い事例を、現在も同じ不具合が続いている証拠として使わないようにします。
wrenで行っている運用と導入前に決めること
wrenではClaude・Gemini・ChatGPTを利用し、学習設定をオフにしています。顧客情報はマスクし、個人情報を入力しない運用です。ゼンナゲCSでは権限管理とMFAを導入し、監査ログを取得しています。再委託は行わず、契約終了時にはデータを削除します。いずれも2026年11月16日に代表が確認した運用です。
自社で導入する場合は、次の事項を担当者が参照できる形にします。
- 使用するサービスとプラン。 業務の用途、契約主体、設定確認日も記録する。
- 入力を禁止する情報。 顧客情報、秘密情報、認証情報について具体的な例を示す。
- 連携の承認者。 接続先と権限を確認し、停止する担当者も決める。
運用ルールへ落とし込む際は生成AIの社内ルールの作り方を参照できます。業務ごとの入力データや連携先の整理は、wrenのAI導入支援で相談を受け付けています。相談フォームには、対象業務と利用予定のサービスをご記入ください。